4주차 (Ch7~9)
7장. 규모 확장
가상의 대형 고객사가 요청 했다 우리 데이터는 다른 고객과 섞이면 안되니, 전용 환경을 제공해 주세요.
배포 되어 있는 서비스의 현재 문제점
- 리소스 경합 문제: 프로메테우스가 메트릭을 수집하며 리소스를 만이 사용하면 같은 노드에 있는 다른 서비스에 영향을 끼친다.
- 격리 불가 문제: 대형 고객사가 요구한 것은 자신들의 데이터만 존재하고 다른 영향을 받지 않는 것이나 현재 네임스페이스 분리 구조로는 불가능하다.
현재 문제를 개선하기 위해서는 노드풀 분리와 테넌트 분리를 통해 개선해볼 예정이다.
- 노드풀 분리: 역할별로 노드를 나누어, API 노드/모니터링 노드 로 분리한다.
- 테넌트 분리: 고객별로 네임스페이스를 나누고, 리소스를 격리한다.
다시 클로드와 함께 어떻게 문제를 개선해 나갈지 살펴봅니다.
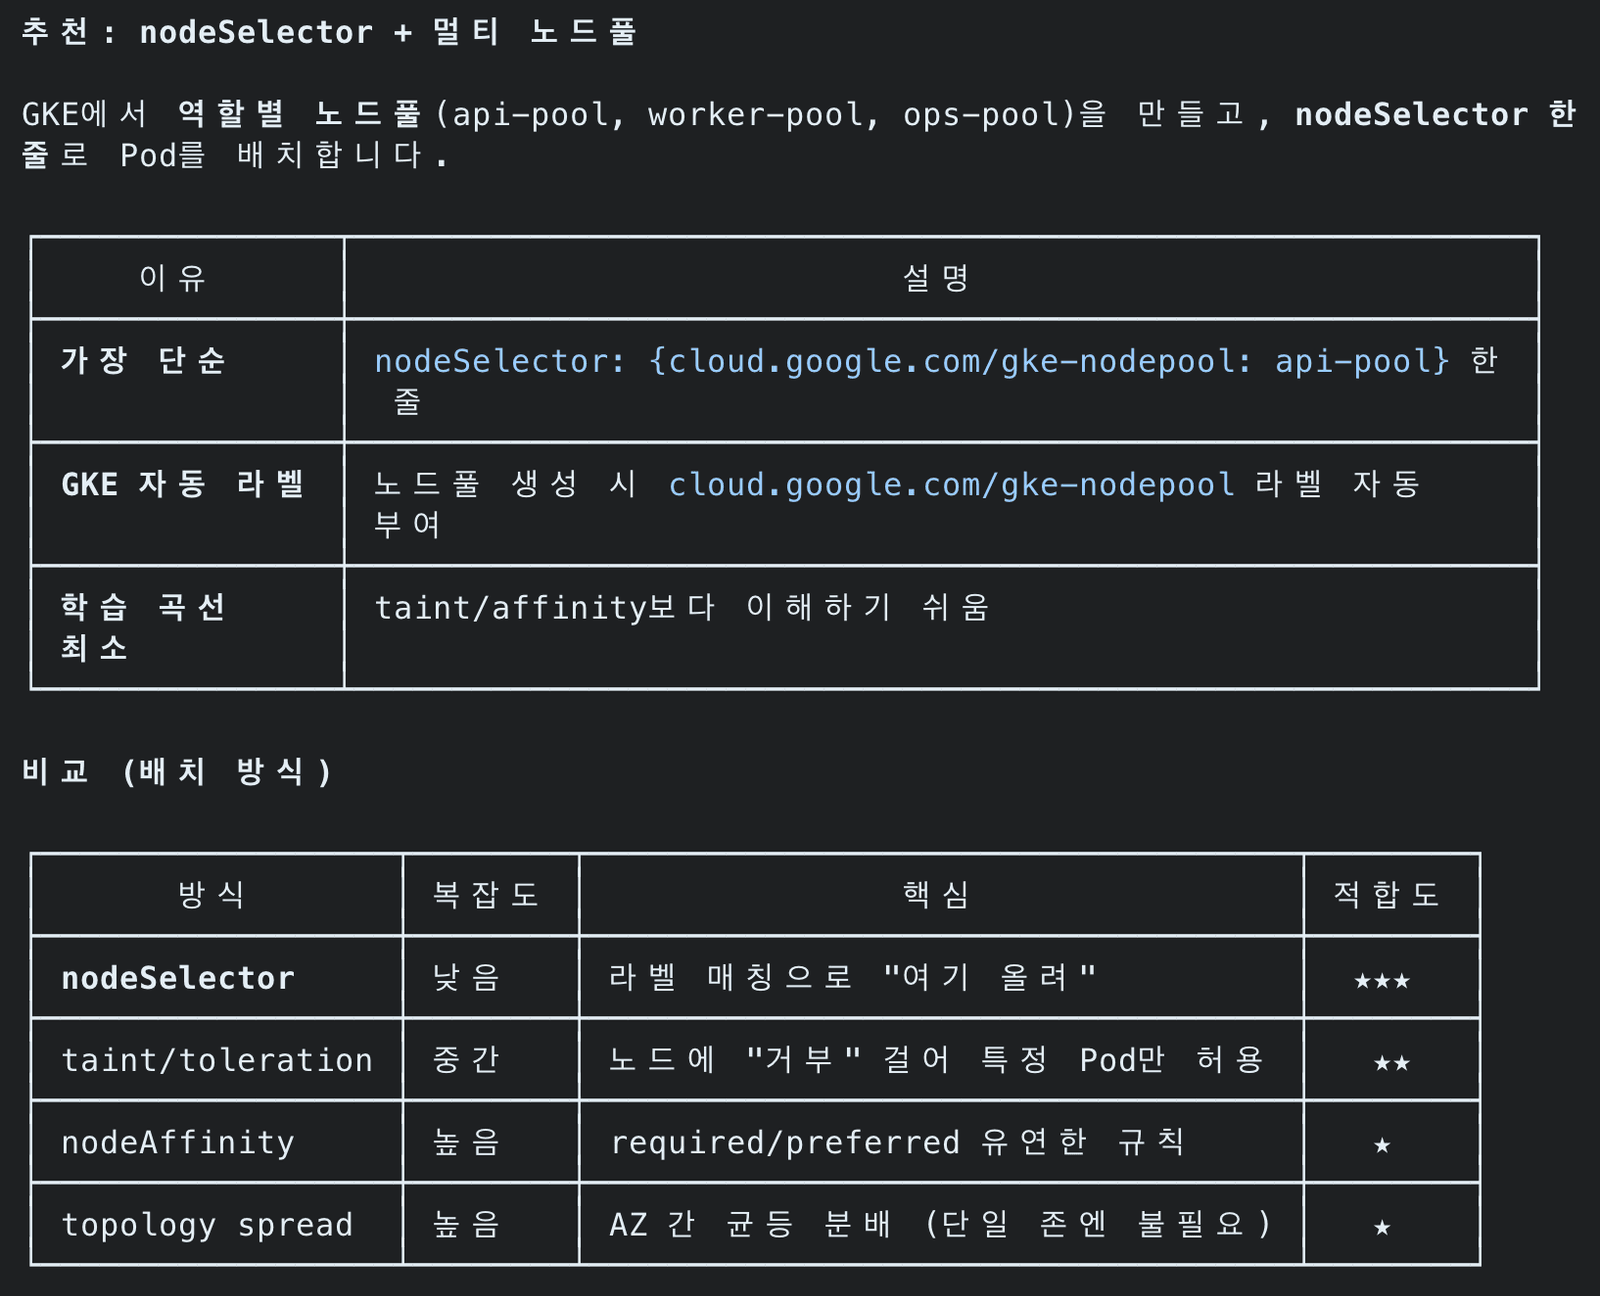
알아두어야 할 개념들
nodepool: 같은 머신 타입, 같은 설정의 노드 그룹으로 노드풀 별로 설정을 다르게 관리할 수 있다.Node Selector: Pod 가 지정된 라벨의 노드로만 스케줄 되도록 설정하는 조건이다.
빠트릴 수 없는 각 설정 별 비교도 해봐야겠죠. 자주 사용되는 노드 셀렉터와 톨러레이션을 기준으로 비교 해보고, 노드 어피니티는 간략하게 살펴보고 토폴로지는 해당 섹션에서 사용되지 않기 때문에 제외하겠습니다.
| 방식 | 설명 |
|---|---|
| nodeSelector | 노드 셀렉터는 라벨이 지정된 노드에 파드가 속할 수 있도록 스케줄 조건을 포함 하는 방식이며, 파드가 노드를 고르지만 라벨이 지정되지 않은 노드도 자원의 상황에 따라 스케줄링 될 수 있다. |
| taint/toleration | 지정한 라벨이 속한 파드는 노드에 스케줄링 될 수 없다는 조건으로, 노드 셀렉터와 반대되는 개념이며 노드 셀렉터만 사용했을 때 라벨이 지정되지 않은 파드가 오게 되는 경우를 막을 수 있다. 다만, 노드와 파드에 둘 다 설정이 필요하여 한 곳이라도 누락 되면 스케줄이 되지 않는 단점이 있다. |
| nodeAffinity | 가능하면 지정된 노드에 스케줄링 되는 것을 요구하지만, 만약 상황에 따라 안되는 경우에는 다른 곳에 스케줄링 되도 괜찮은 경우이다. - preffered: 유연 - required: 강제 |
노드 풀 분리 결과보기
| 노드풀 | 머신 타입 | 설명 | 워크로드 | 노드 셀렉터 설정 |
|---|---|---|---|---|
| default-pool | ec2-medium | 시스템 기반의 애플리케이션 항목 배치 | kube-dns, CSI Daemon Set 등 | 없음 |
| api-pool | ec2-medium | 서비스 애플리케이션 | notiflex-api | gke-nodepool: api-pool |
| worker-pool | ec2-standard-2 | 메모리 DB, 메시지 큐 같은 스토리지 형 | Valkey, Kafka | gke-nodepool: worker-pool |
| ops-pool | ec2-small | 모니터링 애플리케이션 | Prometheus, Grafana, Loki, Fluent Bit | gke-nodepool: ops-pool |
여러 앱 관리하기
앱이 여러 개일 경우, 매번 개별 앱 마다 배포 스크립트를 실행 시켜야 하는 휴먼 리소스는 어느 순간 누락되기 마련이다.
“ArgoCD에서 앱이 여러 개인데 관리가 힘들어. 한 번에 관리하는 방법 없어?” 라고 물었다.
새 앱을 추가할 때마다 비슷한 애플리케이션 YAML 을 복사해서 만들고 있으니, 이를 체계적으로 관리하는 패턴인 App of Apps 패턴을 추천했다.
App of Apps 패턴은 하나의 루트 애플리케이션이 하위 디렉터리를 감시하고, 그 내부에 있는 개별 애플리케이션의 매니페스트 파일들을 자동으로 배포하는 구조이다.
그 외에 ApplicationSet, kubectl 을 이용한 매니페스트 직접 배포 방식 등이 있었지만 현재 프로젝트에 가장 적합한 패턴으로 결정한다.
이 패턴을 적용하고 나면 깃허브에 특정 디렉터리 하위를 모두 재귀적으로 탐색하며 관찰하게 되는데, automated 설정인 prune 과 selfHeal 옵션을 활성화 해두어 깃허브에 있는 파일을 삭제하거나 새롭게 생성될 때 자동으로 반영 되게 구성한다.
이렇게 구성된 GitOps 는 더 이상 작업 담당자가 손으로 직접 배포 스크립트를 입력하여 서버를 기동하고, 모니터링 할 필요가 사라지게 되고 배포 방법은 온전히 main 브랜치에 push 또는 PR merge 만 남게 된다.
그럼, 이제부터 자세하게 App of Apps 패턴을 살펴보자
말 그대로 Application을 관리하는 Application 이다.
하나의 루트 Application이 Git 디렉터리를 감시하고, 그 안의 하위 Application YAML들을 ArgoCD가 자동으로 생성/삭제 한다.
그 외에 다른 방법에 대해 언급했었는데, 그 방법과 뭐가 다를까?
- 개별 관리:
kubectl apply -f valkey-app.yaml애플리케이션 마다YAML파일을 적용해야 한다. ApplicationSet: 한 개의 템플릿을 두고 제너레이터를 통해 여러 앱을 한 번에 렌더링 하는 방식이다. 편리한 방법이지만Go언어 기반이며 디버깅과 학습에 난이도가 있는 편이라 전문 관리 조직이 없다면 직관적인 매니페스트 파일로 관리하는 구조가 더 유지보수에 용이하다.
앱을 배포하는 데 상호 의존 관계면 어떻게 순서를 보장할까?
현재 애플리케이션이 사용자의 트래픽을 받기 위해서는 쿠버네티스의 Gateway API 가 앞단에 먼저 배포가 되어야만 트래픽이 라우팅 된다.
ArgoCD 는 이런 의존 관계를 명시할 수 있도록 Sync Wave 라는 기능을 제공하는데, 각 애플리케이션 매니페스트 구성 정보에 sync-wave 애너테이션을 추가 하면 숫자가 낮은 것부터 순차적으로 배포 된다.
멀티 테넌시 전략으로 독립적인 네임스페이스 분리
이 챕터에 들어오기 전, 대형 고객사의 요청은 독립적인 환경에서 데이터를 볼 수 있도록 서비스를 제공해달라고 요청 했었다.
이 부분은 고객사의 요청이 아니더라도 SaaS 플랫폼이라면 여러 고객에게 서비스를 제공하기 위해 리소스가 격리 되어야 하는 것은 기본이다.
“고객별로 환경을 분리하려면 어떻게 해?” 라고 질문했다.
🤖 Namespace 분리 + RBAC 방식을 추천
멀티 테넌시 전략 하나의 클러스터를 여러 “테넌트”(고객사·팀·환경)가 나눠 쓰되, 서로 간섭하지 않게 하는 것을 말 한다.
테넌트: B2B SaaS 에서 각 기업 고객이 하나의 테넌트라고 설명한다.
Namespace: K8s 의 논리적 격리 단위이며, 리소스를 그룹으로 분리한다.
cross-namespace: 서로 다른 네임스페이스의 서비스에 접근하는 행위를 말 한다.
노이지 네이버(Noisy Neighbor): 한 테넌트가 리소스를 과다 사용하여 다른 테넌트에 영향을 주는 문제를 말 한다.
멀티 테넌시 구성 방법으로는 Namespace 분리 방법 말고도, 가상클러스터 방식, 클러스터 별 분리 방식, Namespace + NetworkPolicy 방식 등이 있다.
멀티 테넌시 구성 간 격리 수준 표
| 멀티 테넌시 방식 | 설명 |
|---|---|
Namespace 분리 | 같은 노드, 같은 네트워크, RBAC 로 API 접근만 제한 |
Namespace + NetworkPolicy | 네트워크 격리 추가, Pod 간 통신을 명시적으로 허용해야 함 |
vCluster | 별도 etcd/API 서버, 각 테넌트가 독립적인 K8s API 사용 |
| 클러스터 분리 | 완전히 다른 클러스터, 가장 강력한 격리 수준을 자랑하지만 비용이 비쌈 |
한 테넌트가 리소스를 다 써버려서 노드의 자원이 부족해지면 어떻게 해야 할까?
이와 같은 경우를 대비해서 파드 레벨에서 걸 수 있는 제한 외에, 네임스페이스 레벨에서 걸 수 있는 ResourceQuota 를 설정하여 CPU, 메모리의 상한을 정하여 한 테넌트가 리소스를 독점하는 행위를 막을 수 있다.
ResourceQuota 는 네임스페이스의 총량에 대해 제한을 걸고, LimitRange 는 개별 자원에 대한 제한을 걸기 때문에 두 가지 제약을 같이 걸어야 한다.
ResourceQuota — 네임스페이스 총량 상한
LimitRange — 네임스페이스 내 개별 Pod 기본값, 상한
8장. 고도화
고객사가 실시간 알림을 요청했다 실시간으로 알림을 받을 수 있도록 구성해주세요.
배포 되어 있는 서비스의 현재 문제점
- API 가 알림을 직접 처리하고, 끝나야 응답이 돌아오는 구조이기 때문에 요청이 몰렸을 때 응답이 지연되거나 타임아웃까지 발생할 수 있다.
- 처리 중 Pod 가 OOMKilled 가 발생하거나 시스템의 장애가 발생하여 종료될 경우 처리 흐름이 유실 된다.
- 서비스 간 호출이 복잡해지면서 장애가 생겼을 때 디버깅 지점을 찾기 어렵다.
- 일일 통계 집계나 미발송 알림 재처리를 자동으로 처리해주는 시스템이 없다.
API 가 알림을 처리하고 끝까지 대기하는 동기 형식의 작업을 하지 않고, 비동기 메시지 처리를 도입, 분산 트레이싱 추가, 크론잡 활성화 작업을 진행한다.
비동기 메시지 도구
AI 에게 물었을 때, 메시지 도구는 아파치 카프카를 추천했다. GitOps 스펙에 호환되는 구조로, Kafka 클러스터를 YAML 로 선언하고, ArgoCD 로 관리할 수 있다.
그리고, 메시지를 디스크에 저장하여 컨슈머가 비정상 종료 되더라도 메시지가 유실되지 않는다.
알아 두면 좋은 개념들
Producer/Consumer: API가Topic에 메시지 넣음(Producer), 별도Worker가 꺼내 처리(Consumer)Topic: 메시지 카테고리 (notifications에 알림 이벤트 쌓임)KRaft:ZooKeeper없이Kafka가 메타데이터 자체 관리 (4.0부터 기본)Consumer Group: 여러Consumer가 파티션 분담, 하나 죽으면 다른 게 이어받음Partition: n 개의 작업을 처리 해야 할 컨슈머, 많으면 리소스를 비효율적으로 낭비하고 적으면 부하가 발생한다.
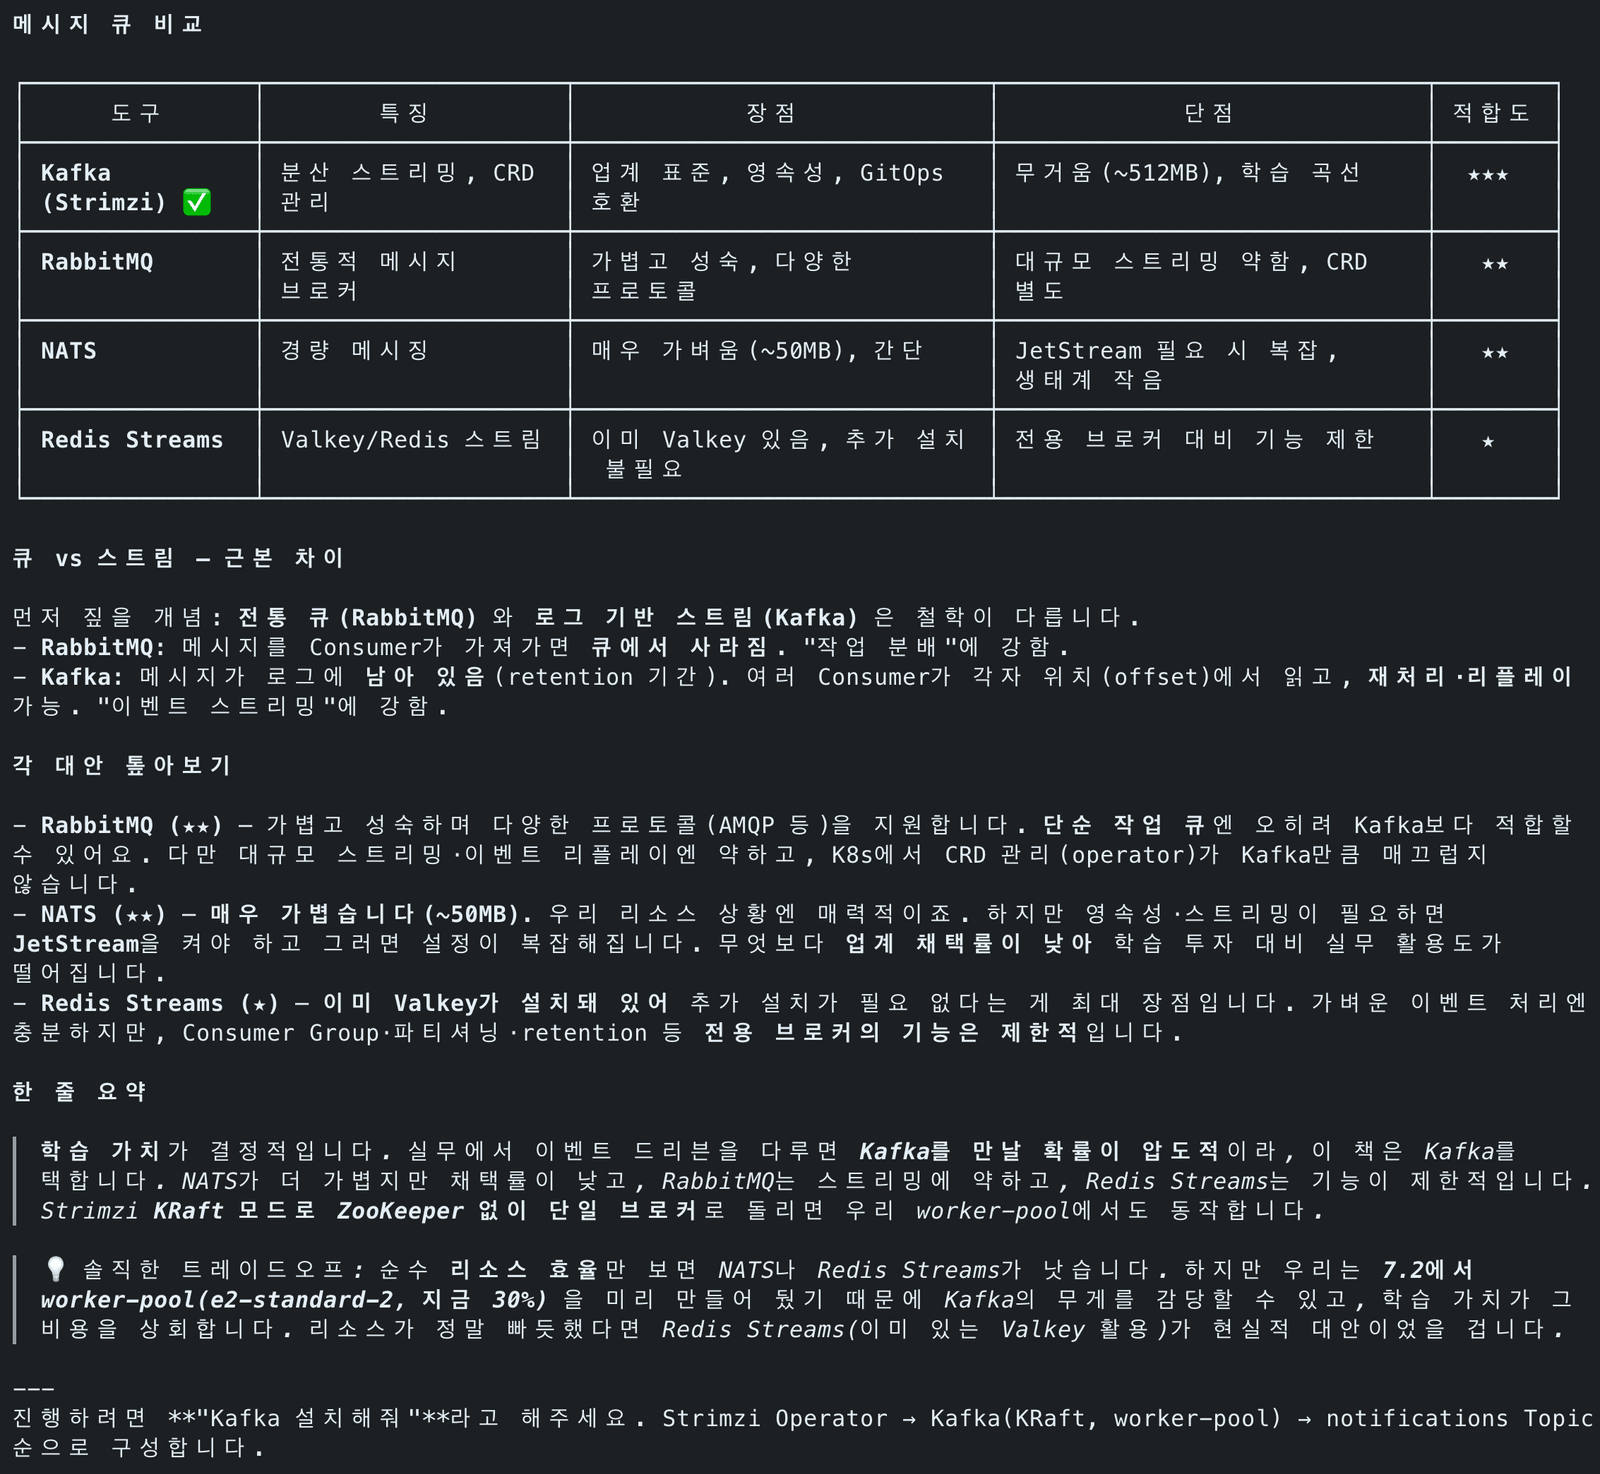
카프카는 데이터를 디스크에 저장 해두고, 컨슈머 그룹이 어디까지 읽었는지 오프셋으로 기록하기 때문에 컨슈머가 메시지를 처리하는 과정에서 비정상 종료 되더라도 다시 재기동 될 경우 마지막으로 커밋된 오프셋부터 읽어 처리하게 된다.
이제 비동기 메시지 큐 작업이 완료되었으니, API 에서 카프카를 거쳐 컨슈머로 이어지는 파이프라인이 구성 되었다.
하지만 현재 구조는 알림이 안 갔을 때 어디에서 막혔는지 추적하기 어렵다.
- API 가 카프카에 발행을 실패 했는지
- 카프카에는 들어갔는데 컨슈머가 소비를 못 했는지
이 모든 상황을 알기 위해서 파드 별 로그를 모두 확인해야 하기 때문에 작업자는 굉장히 번거롭다.
분산 트레이싱
Tempo는 Grafana Labs의 분산 트레이싱 백엔드이다. 트레이스를 저장하고 현재 프로젝트에서 이미 쓰는 Grafana에서 시각화하기 때문에 우리가 사용하기에 적합하다.
현재 프로젝트의 관측 가능성
- 메트릭:
Prometheus,CPU/ 요청 수 등 얼마나 사용되고 있는지 - 로그:
Loki, 에러가 발생하면 무슨 일이 일어났는지 - 트레이스:
Tempo, 어디서 병목이 발생했는지
알아두어야 할 개념
Trace: 한 요청의 전체 여정 (여러Span으로 구성)Span: 단위 작업 — “API 핸들러 50ms”, “Valkey INCR 2ms”, “Kafka 발행 5ms”OpenTelemetry: 트레이스·메트릭·로그 수집 벤더 중립 표준. 앱에 SDK를 넣으면Tempo·Jaeger어디로든 전송 가능OTLP:OpenTelementry전송 프로토콜TraceID: 요청 하나를 식별하는 ID 이며, 모든Span이 공유해 하나로 묶임
각 구간의 시간을 측정하는 방법
각 구간마다 코드에서 Span 이라는 것을 만들어 측정한다. Span 은 특정 시점부터 특정 시간까지 시간을 재는 것을 지정하는 구간이다.
요청 하나가 개별 트레이스가 되고, 그 안의 각 구간들이 Span 으로 표현된다. 코드에서 레디스 같은 통신을 하게 되면 호출하기 전에 Span 을 시작하고, 호출이 끝나면 Span 을 닫는다.
이로써 시작과 끝 사이의 시간이 자동으로 기록 되어 여러 Span 이 모여 하나의 Trace가 구성된다.
트레이싱 추적 모니터링 도구도 다른 것들은 어떤 것들이 있는지 그 대안을 간단하게 살펴 보았을 때, 현재 운영중인 프로젝트의 규모에 따라, 커뮤니티나 기능에 따라 갈리게 된다.
우리는 아래 대안표를 기준으로 두고 프로젝트의 규모가 작기 때문에 가볍고 현재 구성된 모니터링 도구와 통합이 편리한 도구를 선택한다.
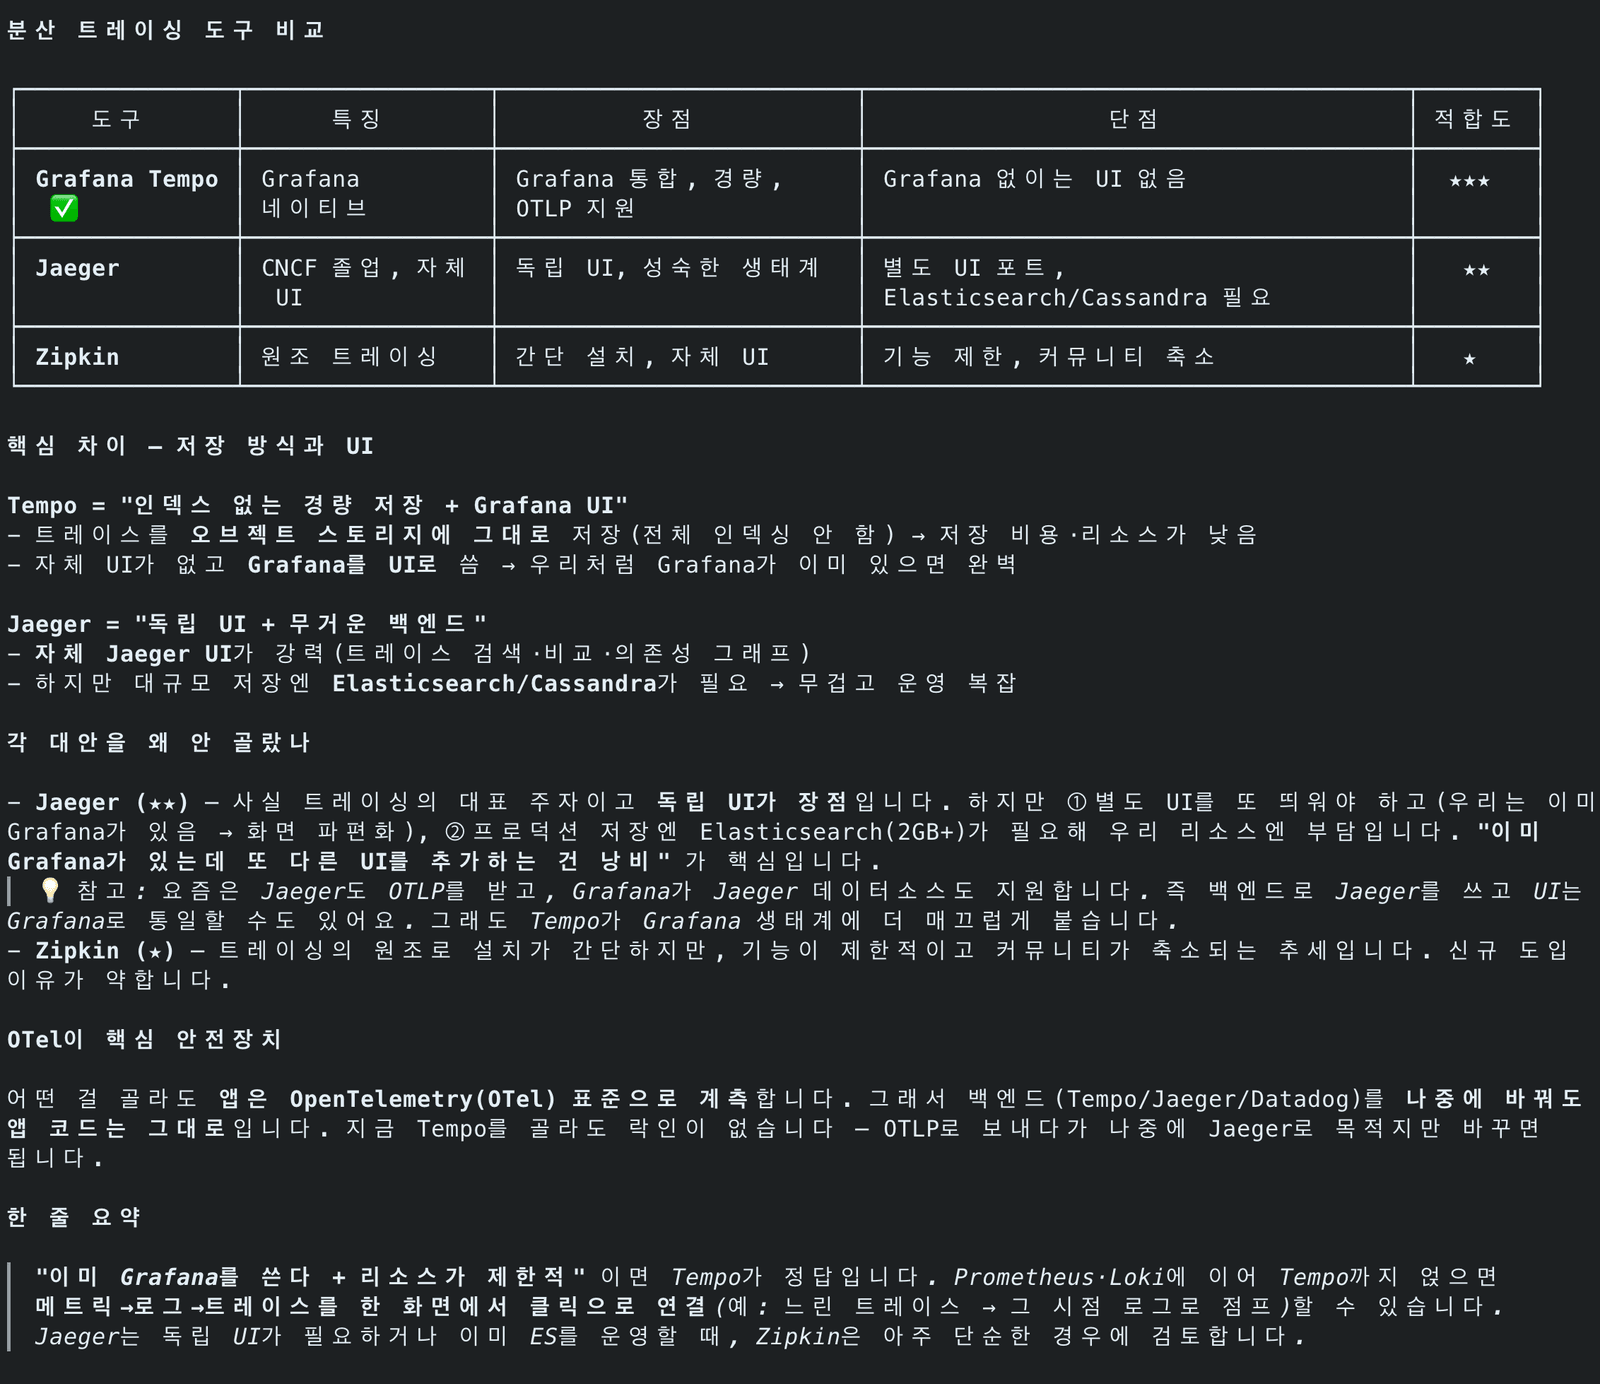
우리 프로젝트에서 Tempo 를 사용하기로 결정했다. 그런데, 아래 내용을 보면 어떤 걸 골라도 앱은 OpenTelementry 를 표준으로 지표를 수집한다고 한다.
이 내용을 살펴보면, Tempo 에 직접 보낼 수 있지만 OpenTelementry 를 거쳐 수집하게 되는 구조이다.
그럼 왜 이렇게 불 필요해 보이는 모니터링 계층이 추가된걸까?
Tempo 에 직접 보낼 수 있지만, 그러면 애플리케이션이 Tempo 라는 도구에 완전히 종속적인 관계가 된다.
나중에 Tempo 를 Jaeger 로 바꾸거나, 여러 백엔드에 동시에 보내고 싶으면 애플리케이션 코드를 전부 수정해야 한다.
그래서, OpenTelementry SDK 로 트레이스를 생성하고, OTLP 프로토콜로 내보내어 도구에 종속되지 않고 구성할 수 있게 된다.
트레이싱을 구성하다보면, span 의 범위를 지정하는 것에 대해 고민이 많다. 너무 자세한 내용까지 기록하기 위해 함수 단위에서 컨트롤 하다보면 노이즈가 많이 생기게 되고, 부족한 경우 정보의 사각지대가 생기게 된다.
그래서 이러한 고민거리를 해결하기 위해서 하나의 원칙을 세우는데, 그 원칙은 경계를 넘는 지점에 넣는 것이다.
span 을 사용하기 좋은 위치
- HTTP Handler: 요청이 들어오는 진입점으로 전체 소요 시간을 잡을 수 있다.
- 외부 시스템 호출: DB, Message Queue, 외부 API, 캐시 등 네트워크를 통하는 구간에서 병목 지점을 찾을 수 있다.
- 오래 걸리는 CPU 작업: 실제 무거운 작업이 얼마나 소요 되는지 알 수 있다.
- 시스템 내 명확한 논리 관계: 예약 -> 결제 등 의존성이 명확하여 서로 연결된 구조일 때, 흐름을 놓치지 않게 유지할 수 있다.
9장. GitAIOps, 살아있는 운영 표준의 탄생
Notiflex Platform 분석
이번 챕터는 지난 프로젝트들을 고도화 하는 과정을 겪으면서 회고 하는 챕터이며, 클로드와 함께 지금까지 만들었던 내역들을 정리한다.
개요
| 항목 | 값 |
|---|---|
| 앱 | Go 표준 라이브러리 + sarama·valkey-go·otel (main.go 252줄) |
| 파일 | 43개 (YAML 28 · MD 9 · Go 1) |
| 라인 | YAML 959 · MD 575 · Go 252 |
| 커밋 | 42개 (2026-07-05~08-08, 작업 12일) |
| 커밋 타입 | feat 16 · ci 8 · docs 7 · fix 3 · chore 1 |
클러스터
| 항목 | 값 |
|---|---|
| 클러스터 | notiflex-cluster (GKE Standard, Zonal) |
| 리전/존 | asia-northeast3 / -a |
| 외부 진입점 | Gateway → 35.216.9.7 (관리형 L7 LB) |
| 활성 기능 | Gateway API · Workload Identity · Secret Manager CSI |
노드풀
| 노드풀 | 머신 | 수 | 역할 |
|---|---|---|---|
| default-pool | e2-medium | 2 | 시스템+ops 겸용 (~96% 포화) |
| api-pool | e2-medium | 1 | notiflex-api |
| worker-pool | e2-standard-2 | 1 | Valkey · Kafka |
기술 선택에 대한 의사결정
| 영역 | 선택 | 기각한 대안 |
|---|---|---|
| GitOps / CI | ArgoCD / GitHub Actions | Flux / Jenkins |
| 메트릭·로그·트레이스 | Prometheus / Loki / Tempo | Datadog / ELK / Jaeger |
| 알림 | PrometheusRule+Alertmanager | Grafana Alerting |
| 트래픽 / 배포 | Gateway API / Argo Rollouts | Ingress NGINX / Flagger |
| 캐시 / 시크릿 | Valkey / Secret Manager CSI | Redis / Sealed Secrets |
| 확장 | 노드풀·App of Apps·멀티테넌시 | taint / ApplicationSet / vCluster |
| 메시징 / 배치 | Kafka(Strimzi) / CronJob | RabbitMQ / Airflow |
모니터링
| 도구 | 역할 | 상태 |
|---|---|---|
| Prometheus | 메트릭 | ✅ (5m 축소) |
| Loki+Fluent Bit | 로그 | ✅ |
| Tempo | 트레이스 | ✅ |
| Alertmanager | 알림 | ✅ |
이 구조로 새 프로젝트를 추가 하려면
이 구조에서 새 마이크로서비스를 추가 하려면 3 단계를 거치게 된다.
app/디렉터리에 새 서비스 코드 작성 -> 애플리케이션 코드k8s/<service-name>/디렉터리에Rollout+ServiceYAML매니페스트 작성 -> 쿠버네티스 리소스 선언문argocd/apps/<service-name>.yaml추가 ->ArgoCD감시 앱 등록
즉, 정리 해보자면 애플리케이션 코드를 작성하고 쿠버네티스 리소스를 선언한 뒤 ArgoCD 에 등록 해주면 자동화 된 배포 모델을 이용할 수 있게 된다.
학습을 위한 프로젝트가 프로덕션 레벨로 성장하려면 어떻게 해야할까?
현재 구조는 학습자 개인의 편의성을 위해 파드 간 통신, 권한 제어 제외, 노드풀 오토 스케일링 등 이 고려되지 않았다.
-
Network Policy
쿠버네티스는 기본적으로 모든 파드 간 통신이 자유롭다. 만약, 특정 테넌트에 비인가 된 사용자가 접근했다면, 다른 파드에 명령어를 통해 접근이 가능하다.
이러한 자율적인 행동 범위를 제한 하여, 필수적으로 통신해야 하는 파드가 아닌 경우 접근이 불가능하도록 할 수 있다.
-
RBAC
현재 테넌트에 대한 접근 권한이 모두 허용되어 있어 한 고객사를 담당하는 담당자가 다른 고객사의 자원들을 모두 볼 수 있다.
이 경우도 마찬가지로, 타 고객사 담당자가 다른 고객사의 자원을 본 뒤 정보를 유출하는 등의 행위가 충분히 가능할 수 있기 때문에 “담당자 또는 서비스” 별 권한을 최소화 하는 것이 필요하다.
-
HPA
트래픽이 몰려 노드가 버티지 못하고, 파드는 노드 스케줄링을 대기하는 무한 펜딩 상태가 된다면 매번 직접 제어해야 한다.
직접 제어 할 경우 장애를 인지하고 실제 작업을 진행하는 시간 까지의 어느정도 텀이 발생하기 때문에 이상 지표가 탐지될 때 바로 조치될 수 있는 전략을 세우는 것이 좋다.
책을 읽고 난 후
클로드 코드와 협업하면서 내가 얻어가야 할 것은 무엇인가?
클로드 코드 세션에서 각종 의사 결정을 하게 되고, 그 근거를 항상 명확히 해야 한다. 하지만 AI 를 통해 작업을 진행하다 보면 한 두번의 정확한 해답이 신뢰가 쌓이게 되고 전적으로 믿고 맡기게 된다.
이 과정을 지나고 나면 나의 머릿속은 하얀 백지가 되고, 결과는 남는다. 이제 스스로에게 다시 “어떻게” 또는 “왜” 라는 질문을 던져보면 대답을 못하는 경우가 많다.
그렇기에 중요한 것은 문서화이다.
이 책에서 안내해주는 방향은 개인 의사결정 근거를 기록하는 메모리 영역과 팀 의사결정을 돕는 ADR 영역 그리고 시스템의 전반적인 아키텍처를 다루는 영역으로 분리한다.
클로드 코드의 지식 구조
CLAUDE.md: 항상 지켜야 할 규칙이며, 매 세션 마다 로드한다..claude/memory/: 개발 결정의 이유와 개인의 작업 컨텍스트이고, 필요할 때만 참조한다.claude-context/: 현재 아키텍처의 전체 그림이며 CLAUDE.md 에서 참조되어 로드된다.