3주차 (Ch5~6)
5장. 무중단 배포
Rolling Update 는 왜 서비스가 끊기는가
Rolling Update 는 설정 값에 따라 파드를 교체하는데, 이전 챕터에서는 50% 설정 값에 의해 절반만큼의 파드를 먼저 교체하고 나머지를 그 후에 교체하는 방식을 사용했다.
Rolling Update 가 발생하는 순간 벌어지는 일
Rolling Update 의 철학은 새 Pod 가 Ready 상태가 될 때까지 기다린 다음에야 기존 Pod 를 내리고, 그 사이 서비스가 두 버전 모두에 트래픽을 분배한다. 이 철학만 보면 잘 설계된 메커니즘이다.
하지만 여기서 발생하는 중단 지점은 Ready 의 개념과 실제 요청을 받을 준비가 된 상태의 개념이 다르다는 것이다.
readinessProbe가/health에서 200 을 돌려주는 순간Pod는 Ready 상태가 된다.- Ready 상태인
Pod가 첫 트래픽을 받을 때, 커넥션 풀 초기화나 캐시 워밍업이 끝나지 않았을 수 있다.
서로 다른 개념이 가져오는 큰 문제점은 검증 시점이다. Rolling Update 는 배포가 시작되자마자 신규 트래픽의 일부가 곧바로 새 버전으로 흘러간다. 새 버전의 상태를 전혀 고려하지 않으며, “10분 동안 서비스가 괜찮으면 트래픽을 받아야지” 같은 개념이 아예 존재하지 않는다.
이로써 배포와 동시에 트래픽을 받다 보니, 장애가 있는 버전이 배포되었더라도 롤백을 결정할 때에는 이미 장애가 발생한 이후가 된다. 게다가 롤백 과정도 이전 ReplicaSet 을 다시 띄우고 새 ReplicaSet 을 내리는 Rolling Update 방식이기 때문에, 실제로 기존 버전으로 트래픽이 완전히 복구되기까지 수십 초 이상 걸리며 그 사이 문제는 지속된다.
쿠버네티스 서비스를 외부에서 접근하기
Ingress 와 Gateway API
Ingress 와 Gateway API 는 궁극적으로 L7 계층에서 외부 트래픽을 클러스터 안의 Service 로 라우팅하는 공통 목적을 가진다.
Ingress 의 한계
- 단일 리소스에 모든 걸 담아 역할 분리가 없다
Ingress오브젝트 하나에LB·IP·TLS같은 인프라 관심사와 경로 라우팅 같은 애플리케이션 관심사가 섞여 있어, 데브옵스 조직과 개발 조직이 분리해서 관리할 수 없다. - 과다한 어노테이션 사용
Ingress스펙은 host + path 라우팅만 정의한다. 그 외 부가 내용(TLS 정책, 타임아웃, 리다이렉트 등)은 전부 컨트롤러별 어노테이션으로 관리한다. - HTTP host/path 외에 빈약한 스펙 코어 스펙은
TCP/UDP/gRPC, 헤더 기반 라우팅, 트래픽 분할 등을 지원하지 않는다.
Ingress 와 가장 큰 차이는 역할 기반 리소스 분리를 지원한다는 것이다.
- GatewayClass 어떤 구현체를 쓰는가 — 클라우드 또는 컨트롤러 제공자가 정의
- Gateway 어느 IP/포트로 통신하는가 — 데브옵스 조직
- HTTPRoute 어느 경로를 어떤
Service로 보낼까 — 개발 조직
각 역할이 분리되어 있어 역할에 맞는 리소스만 변경하면 된다. 또한 Gateway API 는 기본적으로 가중치 트래픽 분배를 지원하여 카나리·Blue/Green 배포 설정이 수월하다. Gateway API 는 쿠버네티스 1.27 이후 운영 레벨에서 사용이 권장된다.
readinessProbe 와 HealthCheckPolicy
두 가지 모두 헬스 체크를 위해 동작하지만 통신하는 계층이 다르다.
readinessProbe는 “이Pod를Service엔드포인트에 포함할지”를kubelet이 결정한다.HealthCheckPolicy는 “이 백엔드에 트래픽을 보낼지”를 로드밸런서가 결정한다.
둘 중 하나만 있어도 동작하지만, 외부 로드밸런서는 kubelet 의 판단을 신뢰하지 않기 때문에 로드밸런서 계층에서 직접 한 번 더 확인이 필요하다. 로드밸런서와 Pod 사이에 네트워크 구간이 있기 때문에, 그 구간까지 포함해 “진짜 요청이 가능한지” 확인한다.
무중단 배포 여정
Argo Rollouts 와 Blue/Green 전략
Argo Rollouts 외에도 Flagger 나 Istio 같이 비슷한 역할을 하는 도구들이 있다.
그중 ArgoCD 로 GitOps 를 구성했다면 가장 최적화된 통합을 지원하고, Argo Rollouts Controller 가 리소스를 저렴하게 사용한다.
Flagger 는 트래픽 분할을 직접 하지 않고 Istio·Gateway API·Nginx 등 다른 프로바이더에게 위임한다. 현재 프로젝트에서 Gateway API 로 연동은 되지만 Istio 없이는 기능이 제한적이다.
자주 언급되는 Istio 는 배포 도구가 아닌 서비스 메시이며, 트래픽 분할을 VirtualService 로 직접 할 수 있어 무중단 배포의 엔진이다. Flagger 와 조합하면 강력하지만, 그만큼 비싼 비용을 감당해야 한다(컨트롤 플레인이 기본 메모리 1GB 를 차지하는 편이다).
배포 전략별 특징
- Rolling Update 점진적으로 전환되지만 신규 버전에 장애 발생 시 일부 사용자가 영향을 받음
- Blue/Green 즉시 전환·롤백이 가능하지만 리소스를 2 배로 사용
- Canary 리소스 효율적으로 점진적 전환
Blue/Green 의 대표적 단점은 리소스 2배 사용이다. 현재 Deployment 의 replicas 가 1의 단위 수준이지만, 향후 서비스가 성장해 10의 자리 이상 리소스가 필요해지면 서버는 그 2배의 자원을 확보해야 한다. 예를 들어 20 개의 레플리카 배포를 위해 일시적으로 40 대를 허용할 수 있어야 한다.
Argo Rollouts 는 기존 Deployment manifest 를 삭제하고 Rollout manifest 로 구성을 변경해야 한다. 두 파일이 공존하면 ArgoCD 가 양쪽 모두에 배포하여 Pod 가 중복 생성된다.
현재 Argo Rollouts 로 Blue/Green 전환이 완료되어, 이제 배포 중에 사용자가 끊김을 느끼지 못하게 되었다. 새 버전이 완전히 준비된 상태로 올라오고 30초 동안 확인한 다음 한 번에 트래픽이 전환되며, 문제가 생기면 ReplicaSet 으로 즉시 되돌릴 수 있다. 기존 Rolling Update 의 한계였던 배포와 검증의 역할을 분리해서 관리하게 되었다.
6장. 엔터프라이즈를 위한 기반 정비
배포 되어 있는 서비스의 현재 개선점
Pod가 2개인데 각각 독립적인 메모리에 데이터를 저장하여, 상태 공유가 불가능하다.YAML파일에 비밀번호가 평문으로 저장 되고, 쿠버네티스 시크릿으로 인코딩 하고있다.Blue/Green배포로 한 번에 전환한다. 문제가 생길 경우 전체 고객이 영향을 받는다.
Pod 간 상태 공유하기
지금까지 구성한 Notiflex API 의 /id 엔드포인트는 인메모리에서 카운터를 통해 ID 를 증분 하는 구조로 생성한다.
이 방식은 Pod 가 한 개일 때 문제가 없지만 복수 개 일 때 상태가 공유 되지 않아 독립적인 값을 띄게 되고, 중복 값이 발생한다.
클로드가 제안하는 도구
Valkey:Redis라이센스 변경 전 마지막 버전에서 포크된 프로젝트로 리눅스 재단에서 관리하는 오픈소스이다.Redis: 가장 활발한 커뮤니티를 갖고 있지만 SSPL 라이센스로 변경 되어 상용에 제한이 있다.Memcached: 단순 키-값 구조의 캐시로 가볍고 멀티 스레드를 지원하지만 영속성 및 원자성이 제한 된다.DragonflyDB: 레디스를 정확하게 호환하고 멀티 스레드로 높은 성능과 메모리 효율을 나타내지만, 커뮤니티가 활발하지 않아 러닝 커브가 존재한다.
클로드가 제안한 도구 중 오픈소스로 운영 되고 있고, 레디스와 동일한 환경을 띄고 있는 Valkey 를 선택 하여 진행 한다.
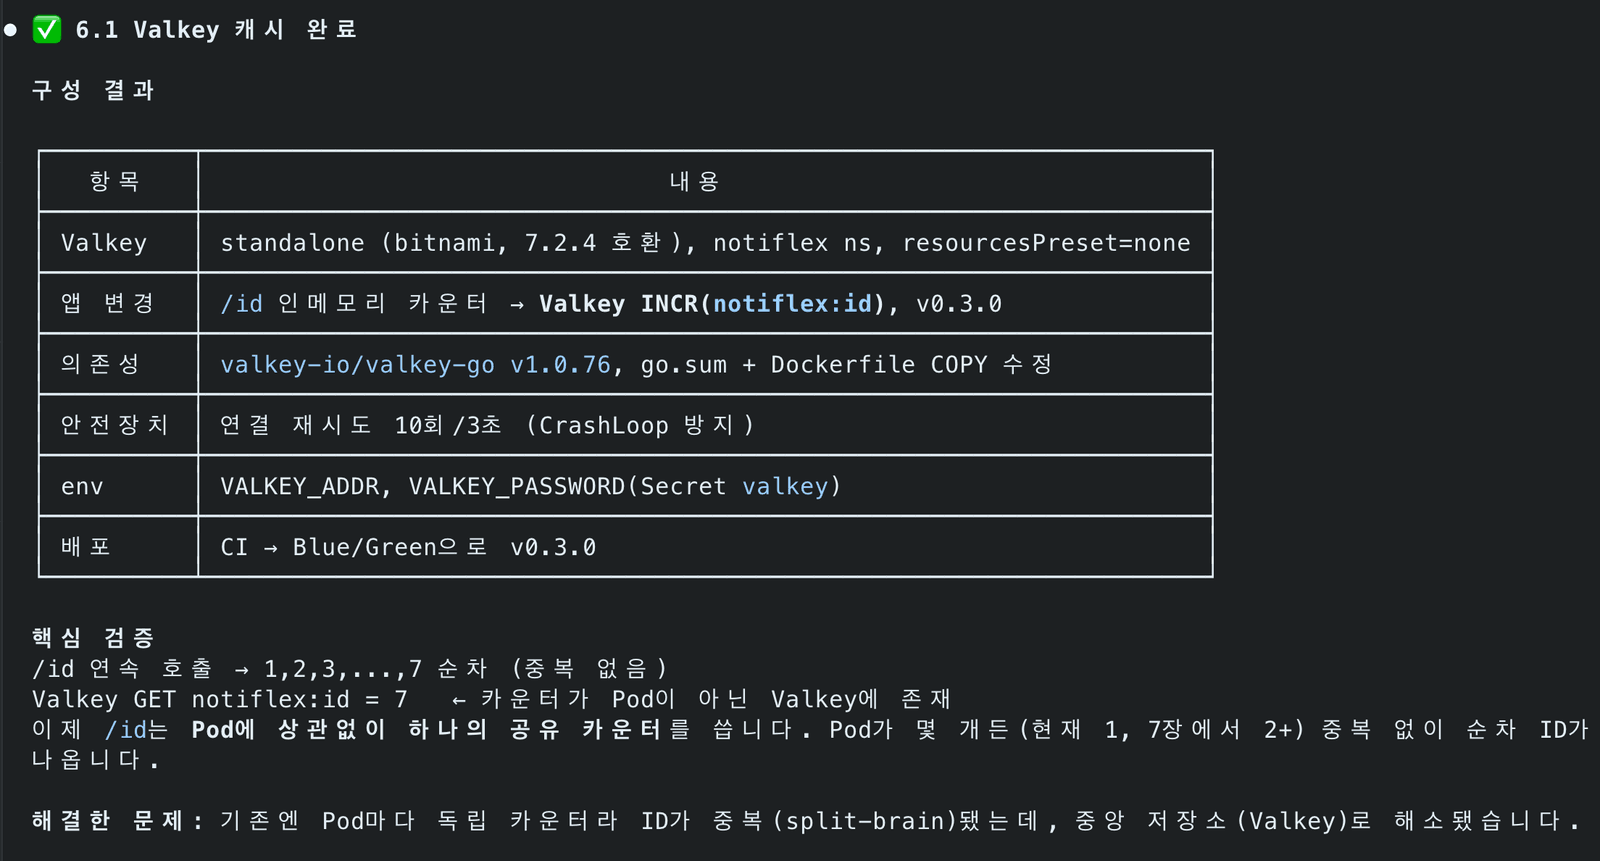
간단한 학습 환경을 구성하기 위해 Bitnami Helm Chart 로 설치했고, 컨테이너 이미지를 Latest 로 무료 버전을 활용 했다.
하지만, 이렇게 AI 를 통해 구성된 서비스는 항상 프로덕션 레벨에서 활용할 수 있는지 검증을 해야 하며 현재 구성안은 오로지 학습 용도로만 쓰인다.
그리고 서비스에서 커넥션을 맺지 못하는 경우 파드가 CrashLoopBackOff 상태로 변하고 무한 재실행 또는 종료 되기 때문에 재시도 정책을 만들어서 관리한다.
쿠버네티스 암호 관리하기
현재 K8S Secret 에 저장된 값은 오로지 평문을 Base64 인코딩 한 값이기 때문에, 값을 조회 하여 디코딩 하면 평문의 암호 값을 얻을 수 있다.
이 값의 보안적인 측면을 신뢰하기 어려우며 프로덕션 수준의 안전한 암호 관리 정책이 필요하다.
클로드가 제안하는 도구
추천: Secrets Store CSI Driver + GCP Secret Manager
CSI Driver+GCP Secret Manager:GCP서비스와CSI마운트가 필요하기 때문에 설정 단계가 복잡한 대신,SA키가 불필요하며 감사 로그를 활용할 수 있다.Sealed Secrets: 암호화 후 깃에 올리는 방식이며GitOps에 100% 호환 되고 실제 LG U+ 에서 소개 할 만큼 운영 환경에서도 쓰일 수 있지만 암호화 키 관리가 필요하다.External Secrets Operator: 별도 오퍼레이터를 설치 하여 외부KMS서비스에 있는 값을 주입하는 형태이다.
👨💻 “Secret 관리 설정해줘” 라고 프롬프트에 입력했다
작업 실행 전 가드레일
CSI를 생성하기 위해 240 밀리코어를 요청 하는 매니페스트가 있었던 것 같다. 요청 자원에 비해 할당하는 노드 자원이 최대치가 넘어 다른 자원의 요청 사양을 줄이는 작업을 진행 했다.
클로드의 작업 목록
Workload Identity가 비활성화 되어있음을 감지 하고, 활성화 명령어를 수행 한다.Secret ManagerCSI애드온을 클러스터에 활성화 한다.
Workload Identity 가 없다면 어떻게 될까?
Workload Identity 는 직역 그대로 워크로드에 접근할 수 있는 신원 증명이다.
k8s 에서는 흔히 SA(Service Account) 를 통해 자격 증명을 관리하는데, 이 방식은 Pod 에서 GCP 리소스에 접근할 때 SA 키 파일을 직접 마운트 해야 하기 때문에 관리 포인트가 생긴다.
반면에 Workload Identity 는 OIDC 토큰을 사용하므로 키 파일이 필요 없으며, GKE 가 관리형 서비스로 제공한다.
CSI Driver 를 설치하면 노드에 어떤 영향을 줄까?
DaemonSet 이 배포되어 노드 수 만큼 Pod 가 생성 되어 암호화 값을 파일로 마운트 하는 방식으로 관리 된다.
CSI driver 를 설치하면 kubelet 의 스토리지 플러그인에 등록 된다.
그 후, Pod 가 암호화 된 값을 요청해야 할 때면 SecretProviderClass 볼륨을 요청하고, CSI driver + provider가 Secret Manager에서 시크릿 값을 조회 하여(이 때 위에서 설명했던 Workload Identity 가 사용됨) 메모리 영역에 해당하는 파일로 Pod 에 마운트하게 된다.
이렇게 마운트 된 파일은 디스크에 직접 저장되지 않고, 메모리에서 관리되는 구조이기 때문에 보다 안전하며 마운트 시점에 Secret Manager 를 호출 한다.
apiVersion: argoproj.io/v1alpha1
kind: Rollout
metadata:
  name: notiflex-api
  namespace: notiflex
  labels:
    app: notiflex-api
spec:
  replicas: 1
  selector:
    matchLabels:
      app: notiflex-api
  strategy:
    blueGreen:
      activeService: notiflex-api            # 실트래픽 (Gateway HTTPRoute 대상)
      previewService: notiflex-api-preview   # 승격 전 검증용
      autoPromotionEnabled: true
      autoPromotionSeconds: 30               # 30초 후 green을 active로 자동 승격
  template:
    metadata:
      labels:
        app: notiflex-api
    spec:
      serviceAccountName: notiflex-api   # Workload Identity 연결된 SA
      containers:
        - name: api
          image: asia-northeast3-docker.pkg.dev/my-gitaiops-project-501506/notiflex/api:sha-2ea193d
          ports:
            - containerPort: 8080
          env:
            - name: POD_NAME
              valueFrom:
                fieldRef:
                  fieldPath: metadata.name
            - name: VALKEY_ADDR
              value: valkey-primary.notiflex.svc.cluster.local:6379
            - name: VALKEY_PASSWORD_FILE
              value: /mnt/secrets/valkey-password   # CSI가 Secret Manager에서 마운트
          volumeMounts:
            - name: secrets
              mountPath: /mnt/secrets
              readOnly: true
          readinessProbe:
            httpGet:
              path: /health
              port: 8080
            initialDelaySeconds: 3
            periodSeconds: 5
          livenessProbe:
            httpGet:
              path: /health
              port: 8080
            initialDelaySeconds: 5
            periodSeconds: 10
          resources:
            requests:
              cpu: 50m
              memory: 32Mi
            limits:
              cpu: 100m
              memory: 64Mi
      volumes:
        - name: secrets
          csi:
            driver: secrets-store-gke.csi.k8s.io
            readOnly: true
            volumeAttributes:
              secretProviderClass: notiflex-secrets
이렇게 암호화 된 데이터를 환경 변수로 지정 했을 때의 장점은 배포 환경 마다 다른 방식으로 주입할 수 있다는 점이다.
샌드박스/베타/프로덕션과 같이 개발 및 운영 환경에서는 관리형 시크릿 매니저를 통해 값을 주입 받고, 로컬 환경은 환경변수로 임의의 값을 넣어줄 수 있다.
Secret 관리 설정이 완료되면
동작 방식의 차이
- 이전 방식과의 차이점은
K8s Secret을 환경 변수로 직접 주입했다. - 현재는
GCP Secret Manager에서 값을 읽고CSI Drvier를 통해 시크릿 값이 들어있는 파일을 마운트하여 파드에서 값을 읽는다.
장점
- 시크릿 값이 깃에 추적되어 관리 되지 않는다.
OIDC를 활용하기 때문에Service Account키 파일 관리가 불필요하다.GCP Secret Manager의 감사 로그를 제공 받을 수 있다.
배포 전략의 변화
지금까지 사용한 방식은 Blue/Green 이었다. 레플리카 수에 맞게 새로운 파드를 준비하고 Ready 상태가 되면 한 번에 전환하는 방식으로 배포 시 노드의 요청 자원 수가 급격히 2배로 늘어나게 된다.
노드 자원을 타이트하게 관리하는 곳에서는 일부 Pending 되어 노드 스케줄러에 의해 할당 받지 못한 파드가 있다면 Green 전환이 불가능하고, 만일 HPA 구성이 되어있다면 배포 만을 위해 노드가 1 대 더 추가 된다는 성능상 단점이 있다.
이를 개선하기 위해 점진적 배포 전략인 Canaray 배포 전략을 사용할 것이며, 앞선 Blue/Green 과 달리 20% -> 50% -> 100% 처럼 점진적으로 사용자 트래픽을 신규 버전에서 받고 문제가 없다면 더 늘려나간다.
이 점진적 배포 과정을 자동으로 제공하기도 하고, 수동으로 작업 담당자가 직접 진행할 수도 있으며 성능 문제를 제기 했었던 리소스 요청량이 2배 -> 1.2 배로 변경된다.
Canary 배포 시 주의할 점
Canary 배포가 마치 만능 배포 전략처럼 들릴지 모르지만 이 전략에도 애플리케이션의 설계에 따라 오류가 발생한다.
20%/80%가 동시에 도니, 두 버전이 공존해도 안전한 애플리케이션이어야 한다.
만약, 서비스 화면이 변경 되었고 20% 만큼의 특정 사용자는 메인 배너에 새로운 화면이 보이는데 나머지 80%는 기존 화면을 보고 있다.
이처럼 버전간 응답이 다른 경우가 아닌, 서로 하위호환이 가능한 범위에서의 배포일 때 유용하다.
배포 전략을 선택하는 근거는 무엇일까?
RollingUpdate, Blue/Green, Canary 와 같이 대표적인 배포 전략 세 가지를 경험 해보면서 각 배포 전략 마다의 장,단점을 알아봤다.
그럼 우리는 앞으로 어떤 상황에서 더 올바른 배포 전략을 선택해야 할지 클로드를 통해 힌트를 얻을 수 있다.
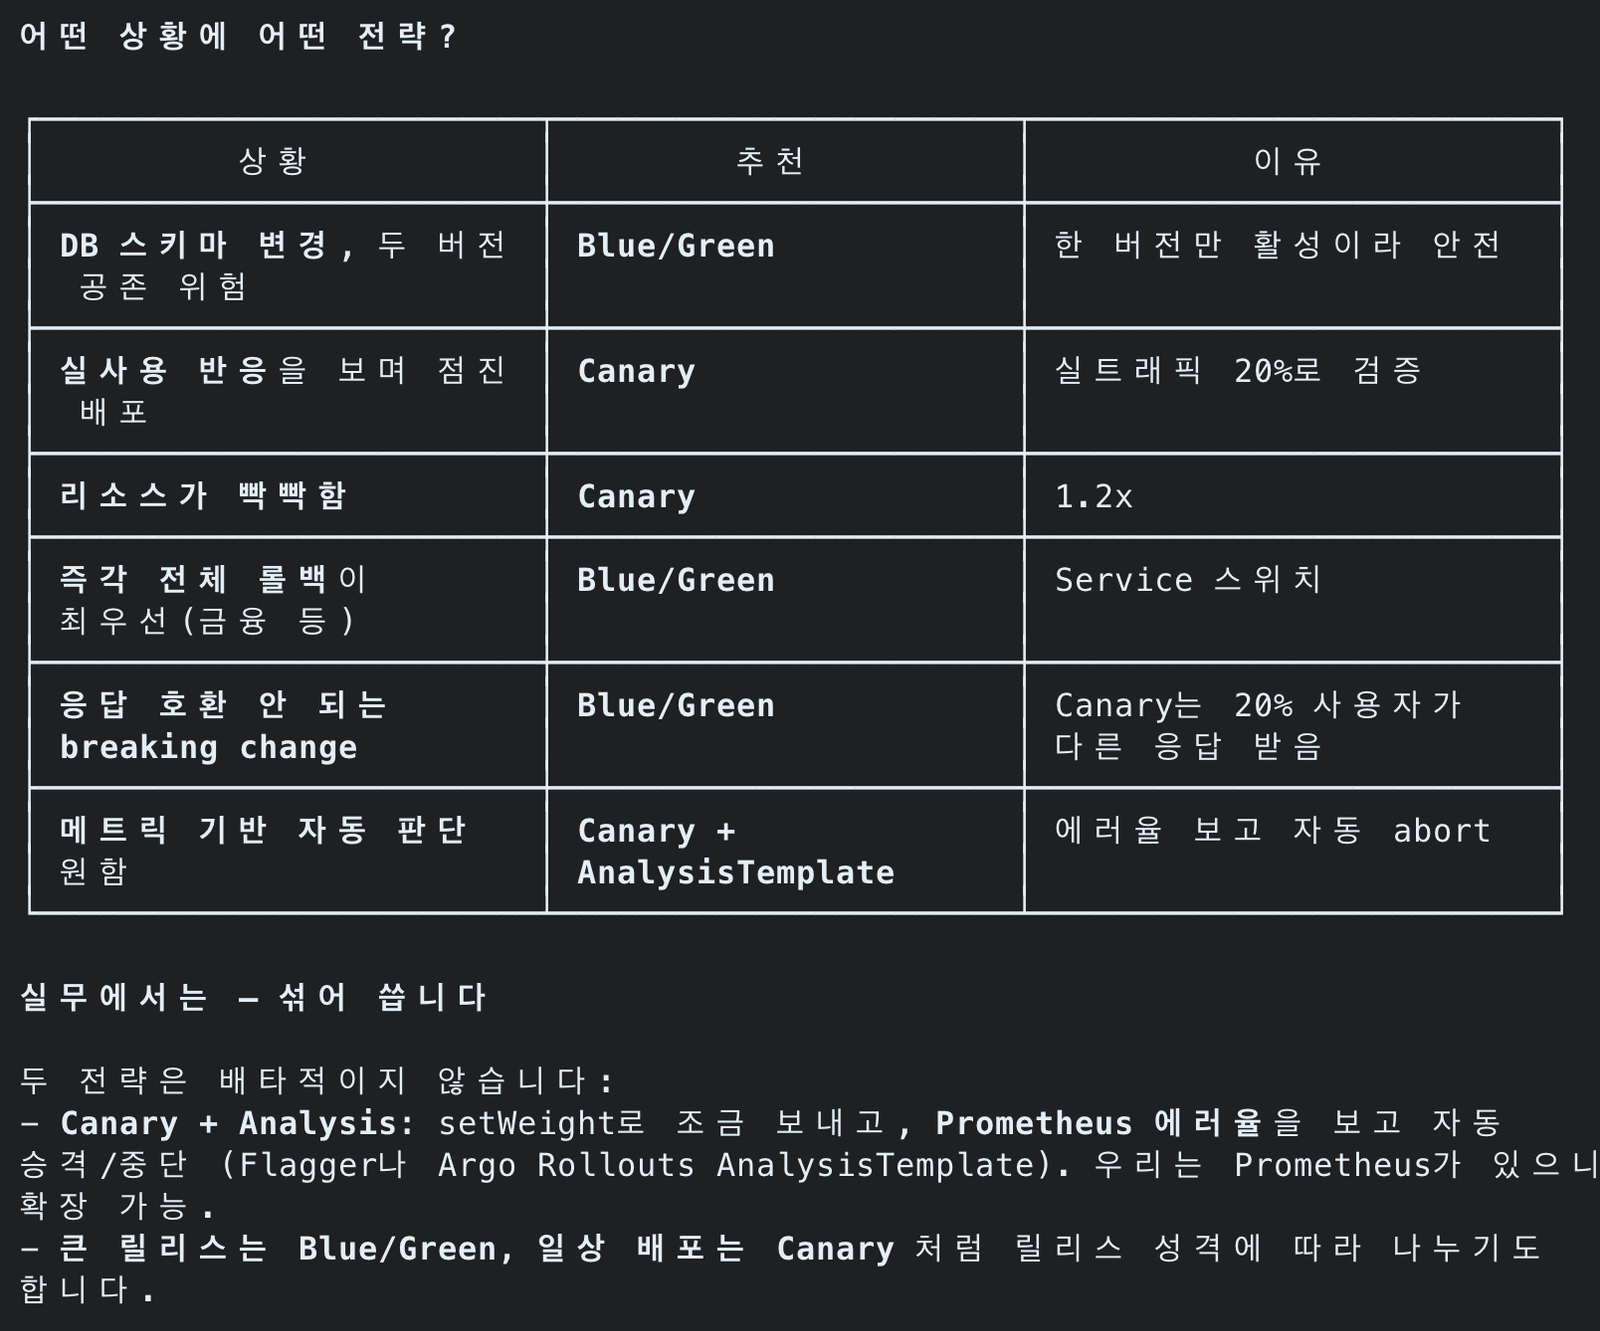
현재 우리 회사의 배포 전략은
우리 회사는 현재 프로덕션에서 Canary 배포를 사용하지만, 수동으로 배포하고 있다. 아무래도 모니터링 툴을 프로메테우스를 사용하지 않고 데이터독을 사용하기 때문에 자동화 조건에 포함 되지 않아서가 맞을 것 같다.
내가 직접 구축했을 때는 기존 CI/CD 가 카나리 전략을 사용하고 있었기 때문에 이질감 없는 이관 전략을 펼치면서 그대로 가져왔었다.
위 AI 가 비교 표를 작성해준 내용을 토대로 다시 돌이켜보면 선택의 근거가 나름 타당한 것 같다.